一、LCVD是什么?
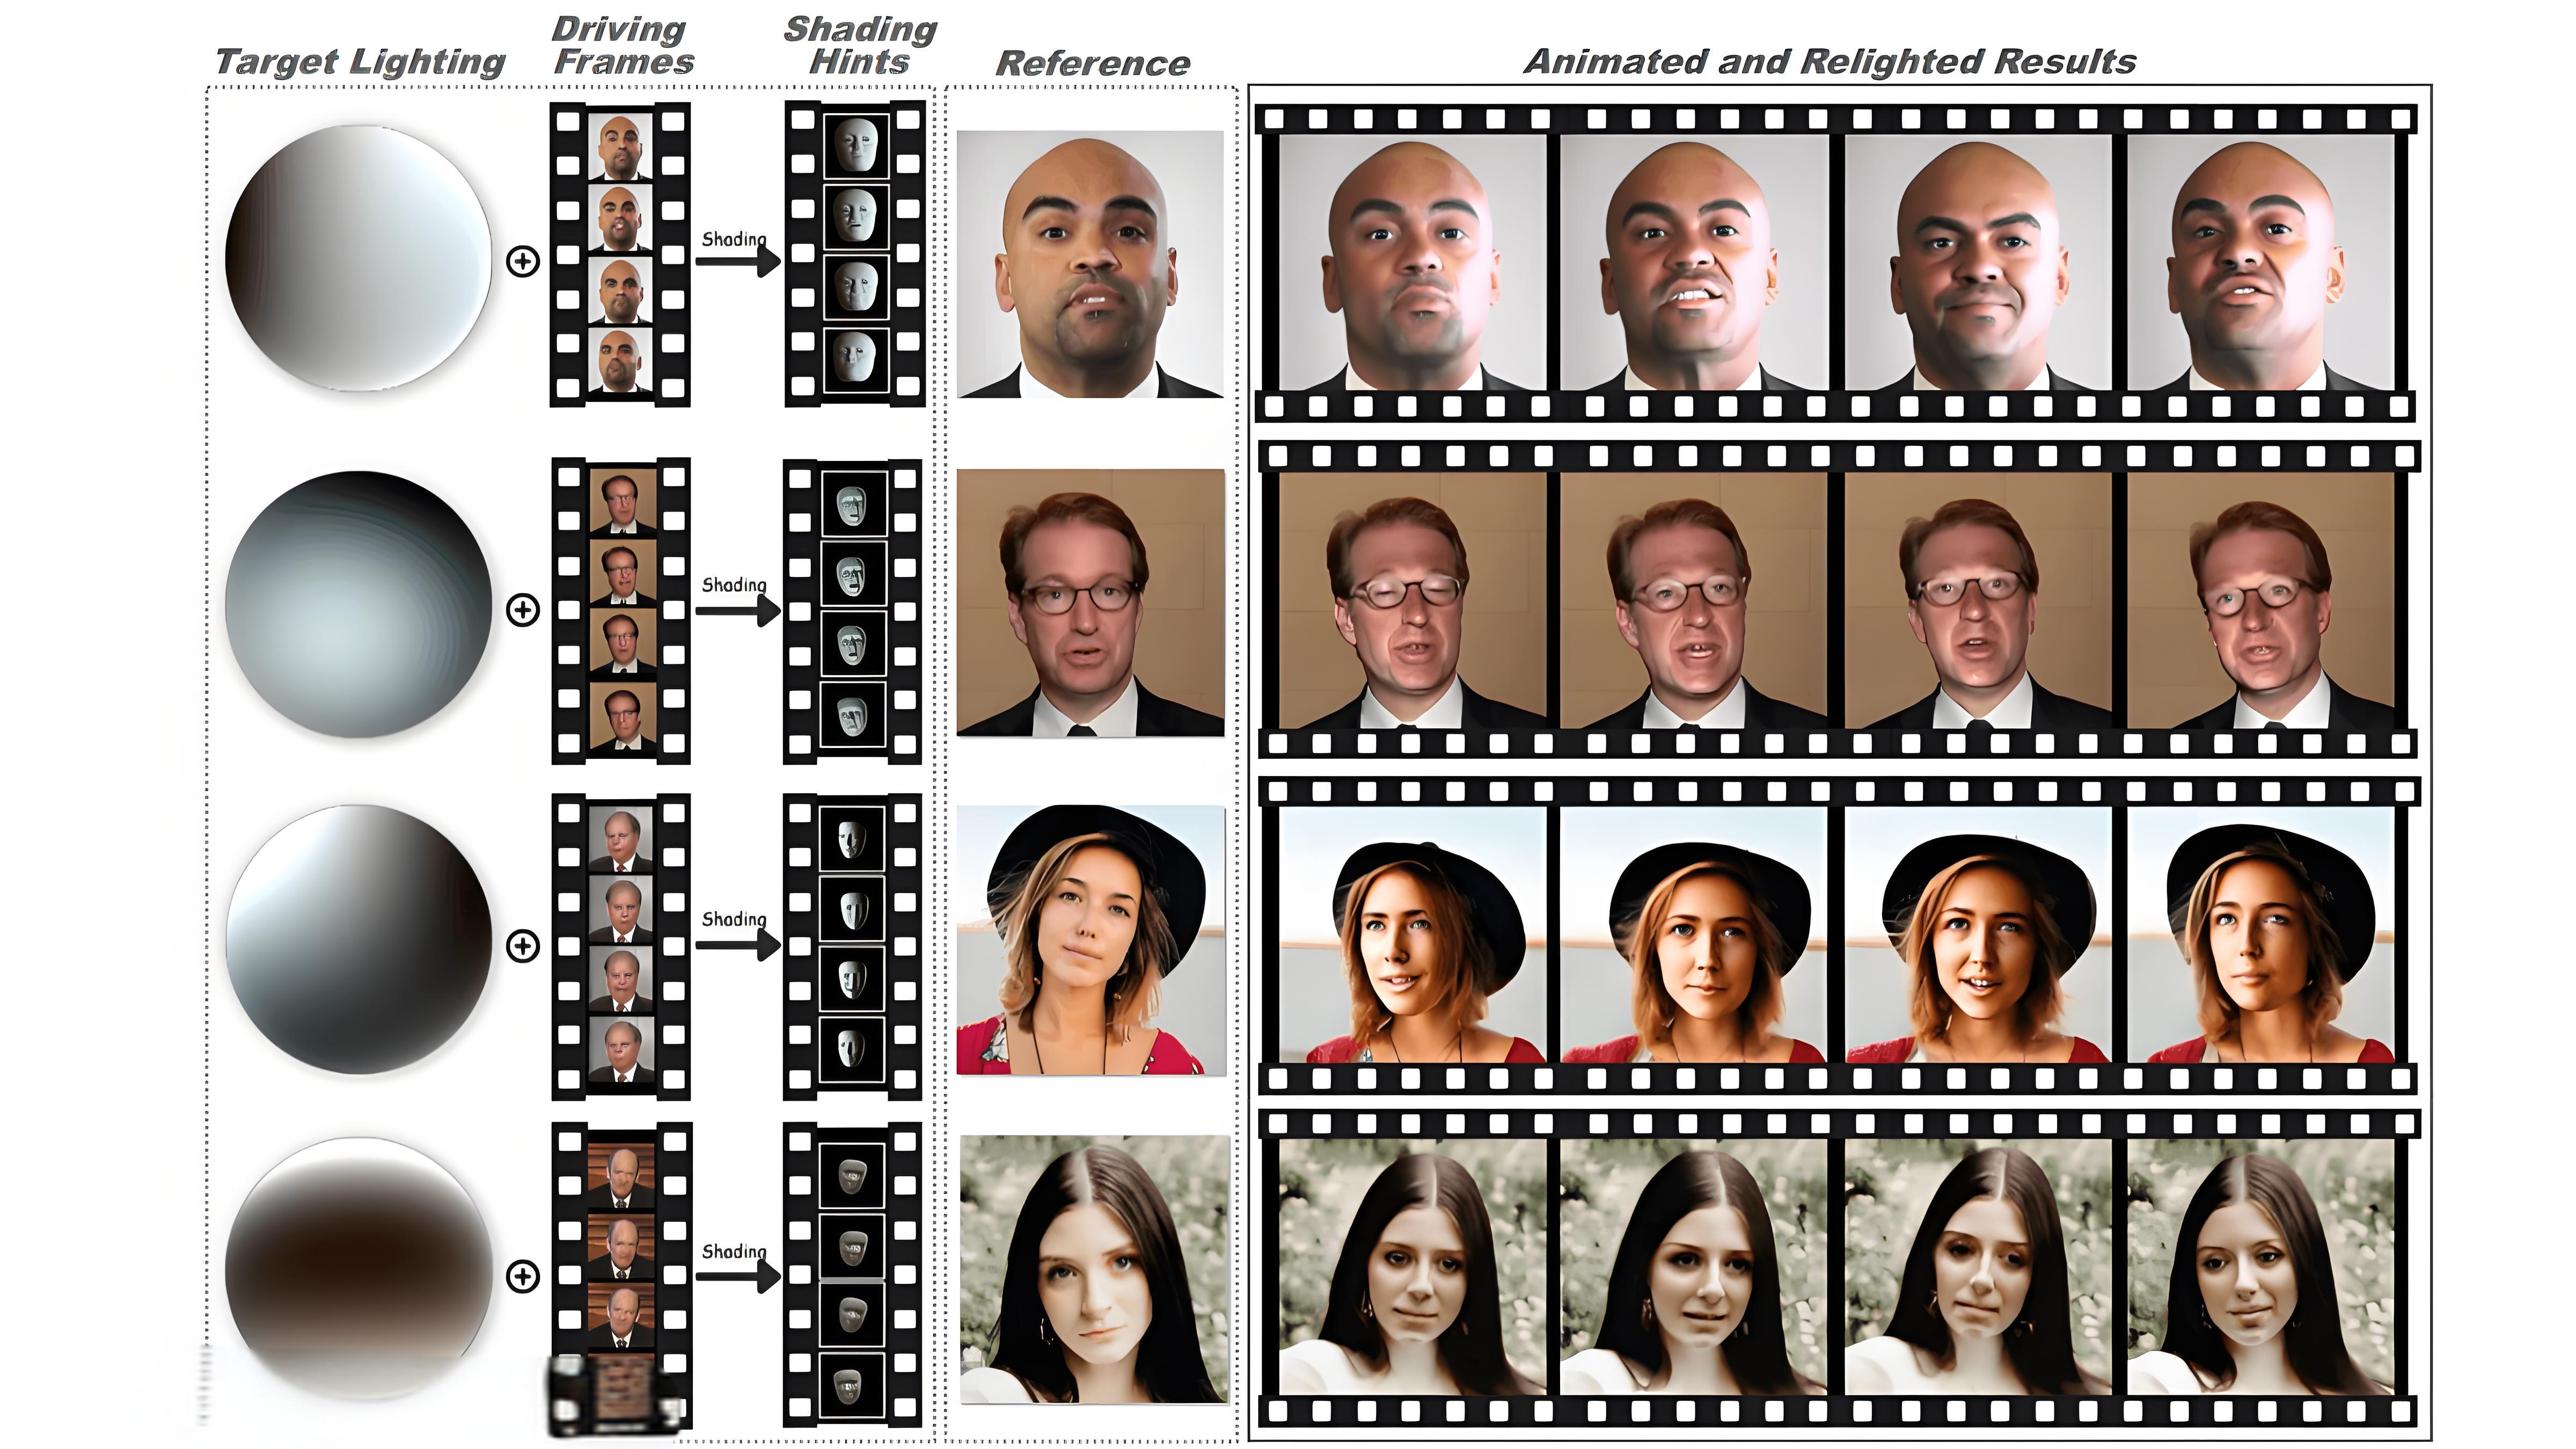
LCVD(Lighting Controllable Video Diffusion Model)是由四川大学推出的高保真、光照可控的肖像动画生成框架。它通过分离肖像的内在特征(如身份和外观)与外在特征(如姿态和光照),结合参考适配器和阴影适配器,将这些特征映射到不同的子空间中。在动画生成过程中,LCVD利用多条件分类器自由引导机制,精细调控光照效果,同时保留肖像的身份和外观特征。基于稳定的视频扩散模型(SVD),LCVD能够生成与驱动视频姿态一致且符合目标光照条件的高质量肖像动画。
二、LCVD的核心功能
-
肖像动画化:将静态肖像转化为动态视频,匹配驱动视频中的头部动作和表情。
-
光照控制:在动画生成过程中,根据用户指定或参考图像的光照条件对肖像进行重打光。
-
身份与外观保留:在动画和重打光过程中,保持肖像的身份和外观特征,避免身份信息丢失。
-
高质量视频生成:生成的视频在光照真实感、图像质量和视频一致性方面表现优异,适合虚拟现实、视频会议和影视制作等场景。
三、LCVD的技术原理
-
特征分离:
-
参考适配器(Reference Adapter)将参考肖像的内在特征(如身份和外观)映射到特征空间。
-
阴影适配器(Shading Adapter)将外在特征(如光照和姿态)映射到特征空间。
-
通过分离内在和外在特征,模型能够在动画化过程中独立控制光照和姿态。
-
-
光照可控的扩散模型:
-
基于稳定视频扩散模型(Stable Video Diffusion Model),利用多条件分类器自由引导(Classifier-Free Guidance)调整光照效果。
-
通过修改引导强度(如权重 ω),增强或减弱光照提示的影响,实现精细的光照控制。
-
-
运动对齐与长视频生成:
-
基于运动对齐模块,确保生成的肖像与驱动视频的姿态一致。
-
采用扩散模型采样方法,生成任意长度的视频,并通过重叠策略确保视频片段之间的平滑过渡。
-
-
训练与优化:
-
在训练阶段,使用自监督学习优化适配器和扩散模型,确保生成的视频在光照、姿态和身份上的一致性。
-
通过损失函数(如 LPIPS、FID 等)评估和优化生成视频的质量。
-
四、LCVD的应用场景
-
虚拟现实(VR)和增强现实(AR):
-
创建逼真的虚拟角色,使其能够与虚拟或现实场景自然融合。
-
-
视频会议:
-
实时生成高质量肖像动画,降低带宽需求,提升用户体验。
-
-
影视制作:
-
快速生成符合不同光照条件的肖像动画,用于特效和虚拟场景制作。
-
-
游戏开发:
-
生成逼真的虚拟角色动画,增强游戏的真实感和沉浸感。
-
-
社交媒体和内容创作:
-
支持用户生成个性化动态头像或短视频,丰富内容创作形式。
-
五、LCVD的项目资源
-
技术论文: 想了解更多技术细节,可以访问LCVD的arXiv技术论文: https://arxiv.org/pdf/2502.19894
总结
LCVD作为四川大学推出的光照可控肖像动画生成框架,凭借其高保真、高质量的视频生成能力,正在为虚拟现实、视频会议、影视制作等领域带来革命性的变化。无论是技术爱好者还是内容创作者,都可以通过LCVD探索更多创新的可能性。如果您对这一技术感兴趣,不妨深入阅读其技术论文,了解更多细节!
相关文章